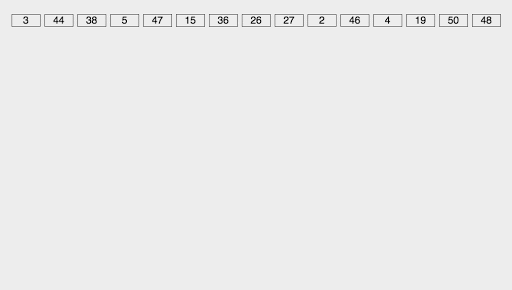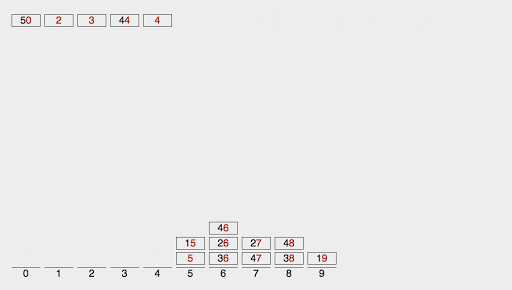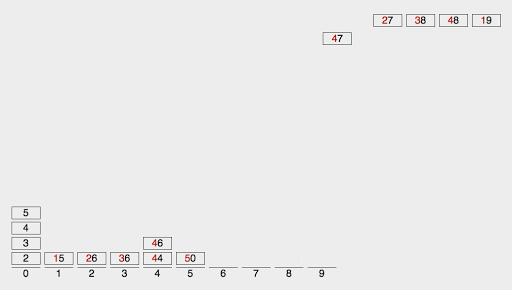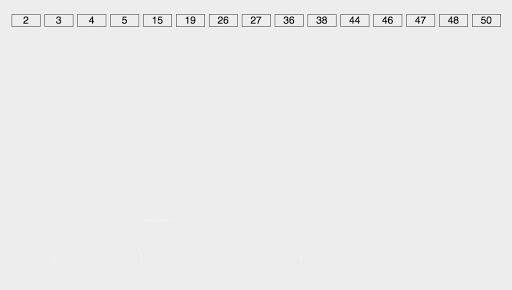
{"componentChunkName":"component---src-templates-post-jsx","path":"/[Algorithm]Sorting 알고리즘/","result":{"data":{"site":{"siteMetadata":{"title":"SUbbb"}},"markdownRemark":{"id":"f3c7f32a-2ead-5bd5-a198-ee5342823217","excerpt":"Sorting 알고리즘은 크게 Comparisons 방식과 Non-Comparisons 방식으로 나눌 수 있다. 🧷 Comparisons 방식 알고리즘 , , , , ,  🧷 Non-Comparisons 방식 알고리즘 ,  Stable sort\n: 중복된 키를 순서대로 정렬하는 정렬 방식이다. 즉, 값이 같은 원소가 있어도 정렬 시 그 순서를 보장하는 방…","html":"<blockquote>\n<p>Sorting 알고리즘은 크게 <strong>Comparisons</strong> 방식과 <strong>Non-Comparisons</strong> 방식으로 나눌 수 있다.</p>\n</blockquote>\n<h2>🧷 Comparisons 방식 알고리즘</h2>\n<p><code class=\"language-text\">Bubble Sort</code>, <code class=\"language-text\">Selection Sort</code>, <code class=\"language-text\">Insertion Sort</code>, <code class=\"language-text\">Quick Sort</code>, <code class=\"language-text\">Merge Sort</code>, <code class=\"language-text\">Heap Sort</code></p>\n<h2>🧷 Non-Comparisons 방식 알고리즘</h2>\n<p><code class=\"language-text\">Counting Sort</code>, <code class=\"language-text\">Radix Sort</code></p>\n<blockquote>\n<p><strong>Stable sort</strong>\n: 중복된 키를 순서대로 정렬하는 정렬 방식이다. 즉, 값이 같은 원소가 있어도 정렬 시 그 순서를 보장하는 방식이다.</p>\n<p><strong>In-place sort</strong>\n: 원소들의 개수에 비해 충분히 무시할만한, 거의 추가적인 메모리 공간을 사용하지 않는 정렬 방식이다.</p>\n</blockquote>\n<hr>\n<h2>🧷 거품 정렬 (Bubble Sort)</h2>\n<p>서로 인접한 두 원소의 대소를 비교하고, 조건에 맞지 않다면 자리를 교환하며 정렬하는 알고리즘이다.</p>\n<ul>\n<li>\n<p>각 회전마다, 첫 번째 원소와 두 번째 원소를 비교하고, 두 번째 원소와 세 번째 원소를 비교하고 교체하는 방식으로 전체 배열을 한 번 순회한다.</p>\n<ul>\n<li>1회전의 결과로 가장 큰 값이 맨 뒤로 이동한다.</li>\n</ul>\n</li>\n<li>다음 회전부터는 맨 끝 원소는 제외하고 이를 반복한다.</li>\n</ul>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void bubbleSort(int[] numbers) {\n  int tmp = 0;\n  for (int i = 0; i &lt; numbers.length; i++) {\n    for (int j = 1; j &lt; numbers.length - i; j++) {\n      if (numbers[j - 1] &gt; numbers[j]) {\n        tmp = numbers[j - 1];\n        numbers[j - 1] = numbers[j];\n        numbers[j] = tmp;\n      }\n    }\n  }\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 장점</h3>\n<ul>\n<li>간단한 구현과 직관적인 코드</li>\n<li>In-place sort</li>\n<li>Stable sort</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>정렬되어 있던, 안되어 있던, 2개의 원소를 비교하기 때문에 최선, 평균, 최악의 경우 모두 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span> 으로 동일하다.</li>\n<li>교환이 많이 발생한다.</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mn>1</mn><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(1)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\">1</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<blockquote>\n<p>❓</p>\n<ul>\n<li>\n<p><code class=\"language-text\">>=</code> 연산을 수행한다면 unstable 할까?</p>\n<ul>\n<li>그렇지 않을까?</li>\n</ul>\n</li>\n<li>\n<p>개선을 위해서는 어떻게 해야 하는가?</p>\n<ul>\n<li>비교를 수행하지 않은 회전이 있다면 바로 정렬을 종료!</li>\n<li>정렬 범위를 계속 업데이트하는 방식</li>\n<li>양방향 버블 정렬</li>\n</ul>\n</li>\n</ul>\n</blockquote>\n<h3>🪚 양방향 버블 정렬</h3>\n<p>정렬 범위를 계속 업데이트하는 개선 방식에 패스의 스캔 방향을 교대로 바꾸는 방식을 더한다. 이를 통해 점점 스캔하는 범위가 줄어들게 된다.</p>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void cocktailSort(int[] numbers) {\n  int left = 0;\n  int right = numbers.length - 1;\n  int last = right;\n\n  while(left &lt; right) {\n    int i;\n    int tmp = 0;\n\n    // 가장 작은 원소가 맨 앞에 위치!\n    for (i = right; i &gt; left; i--) {\n      if (numbers[i - 1] &gt; numbers[i]) {\n        tmp = numbers[i - 1];\n        numbers[i - 1] = numbers[i];\n        numbers[i] = tmp;\n        last = i;\n      }\n    }\n    // 마지막으로 교환이 일어난 위치\n    left = last;\n\n    // 가장 큰 원소가 맨 뒤에 위치\n    for (i = left; i &lt; right; i++) {\n      if (numbers[i] &gt; numbers[i + 1]) {\n        tmp = numbers[i + 1];\n        numbers[i + 1] = numbers[i];\n        numbers[i] = tmp;\n        last = i;\n      }\n    }\n    // 마지막으로 교환이 일어난 위치\n    right = last;\n  }\n}</code>\n        </deckgo-highlight-code>\n<hr>\n<h2>🧷 선택 정렬 (Selection Sort)</h2>\n<p>버블 정렬과 유사한 알고리즘으로, 해당 회전에 원소를 넣을 위치는 이미 정해져 있고, 어떤 원소를 넣을지 선택하는 알고리즘이다.</p>\n<ul>\n<li>각 회전마다, 배열에서 최솟값을 찾는다.</li>\n<li>그 값을 맨 앞에 위치한 원소와 교체한다.</li>\n<li>이후 회전부터는 맨 앞 원소를 제외하고 반복한다.</li>\n</ul>\n<blockquote>\n<p>Insertion sort와 다른 점은, 배열에서 해당 자리를 선택하고, 그 자리에 올 값을 배열에서 선택하여 위치시키는 방식이다.</p>\n</blockquote>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void selectionSort(int[] numbers) {\n  int tmp = 0;\n  for (int i = 0; i &lt; numbers.length - 1; i++) {\n    // 정렬될 원소를 넣을 위치 지정, 왼쪽에서부터 차례대로 수행\n    int minIndex = i;\n    // 최소값을 가지는 인덱스 탐색\n    for (int j = i + 1; j &lt; numbers.length; j++) {\n      if (numbers[j] &lt; numbers[minIndex])\n        minIndex = j;\n    }\n    tmp = numbers[minIndex];\n    numbers[minIndex] = numbers[i];\n    numbers[i] = tmp;\n  }\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 장점</h3>\n<ul>\n<li>간단한 구현</li>\n<li>정렬을 위한 비교 횟수는 많지만, 버블 정렬에 비해 실제로 교환하는 횟수는 적다.</li>\n<li>In-place sort</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>매 회전마다, 정렬된 원소를 제외하고 모든 원소에 대해 비교를 수행해야 한다. 최선, 평균, 최악의 경우 모두 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span> 으로 동일하다.</li>\n<li>Unstable sort</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mn>1</mn><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(1)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\">1</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<blockquote>\n<p>❓ </p>\n<ul>\n<li>\n<p>stable하게 하는 방법은?</p>\n<ul>\n<li>최솟값과의 교환이 아닌, 나머지 원소들을 한 자리씩 뒤로 미는 방식으로 stable하게 할 수 있다.</li>\n</ul>\n</li>\n</ul>\n</blockquote>\n<hr>\n<h2>🧷 삽입 정렬 (Insertion Sort)</h2>\n<p>선택 정렬과 유사하지만, 좀 더 효율적인 방식이다. <code class=\"language-text\">i</code> 번째를 정렬할 순서라고 가정하면, <code class=\"language-text\">0</code> 부터 <code class=\"language-text\">i - 1</code> 번째 원소들은 정렬되어있다는 가정하에, <code class=\"language-text\">i</code> 번째 원소와 <code class=\"language-text\">i - 1</code> 번째 원소부터 <code class=\"language-text\">0</code> 번째 원소까지 비교하면서 큰 경우에만 교환한다.</p>\n<ul>\n<li>2번째 위치의 값을 <code class=\"language-text\">tmp</code> 에 저장한다. (1번째 원소는 정렬되었다고 가정)</li>\n<li>\n<p><code class=\"language-text\">tmp</code> 와 이전에 있는 원소들과 비교하며 삽입해나간다. 이전의 원소들보다 <code class=\"language-text\">tmp</code> 에 있는 값이 작은 경우 교환한다.</p>\n<ul>\n<li>한 회전이 끝나고 나면, <code class=\"language-text\">tmp</code> 애 있는 값을 위치시킨다.</li>\n</ul>\n</li>\n<li>다음 위치의 값(2번째 이후)을 <code class=\"language-text\">tmp</code> 에 저장하고 이를 반복한다.</li>\n</ul>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void insertionSort(int[] numbers) {\n  for (int i = 1; i &lt; numbers.length; i++) {\n    int tmp = numbers[i];\n    int prev = i - 1;\n    // 이전 위치까지의 원소들 중 현재 삽입할 값보다 작은 값이 나올 떄까지 인덱스를 옮김\n    while(prev &gt;= 0 &amp;&amp; numbers[prev] &gt; tmp) {\n      numbers[prev + 1] = numbers[prev];\n      prev--;\n    }\n    numbers[prev + 1] = tmp;\n  }\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 장점</h3>\n<ul>\n<li>단순한 알고리즘</li>\n<li>대부분의 원소가 이미 정렬된 상태라면, 매우 효율적일 수 있다.</li>\n<li>In-place sort</li>\n<li>Stable sort</li>\n<li>최선의 경우(모두 정렬된 경우, 1번씩만 비교를 수행) <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span>의 시간 복잡도를 가지기에, 선택 정렬이나 버블 정렬보다는 상대적으로 빠르다.</li>\n<li>Online 알고리즘</li>\n</ul>\n<blockquote>\n<p><strong>Online alg</strong>\n: 시작하는 시점에 모든 정보를 가지고 있지 않고, 입력을 차례로 받으면서 처리하는 알고리즘</p>\n</blockquote>\n<h3>🪚 단점</h3>\n<ul>\n<li>평균과 최악의 시간복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span>이다.</li>\n<li>배열의 길이가 길어질수록 비효율적이다.</li>\n</ul>\n<blockquote>\n<p><strong>선택 정렬과의 비교</strong></p>\n<ul>\n<li>k번째 반복 이후, 첫 번째 k 요소가 정렬된 순서로 온다는 점에서 유사하지만, 선택 정렬은 k + 1번째 요소를 찾기 위해 나머지 모든 요소를 탐색해야 한다.</li>\n<li>삽입 정렬이 더 효율적인 이유이다.</li>\n</ul>\n</blockquote>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mn>1</mn><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(1)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\">1</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<hr>\n<h2>🧷 퀵 정렬 (Quick Sort)</h2>\n<p>분할 정복을 통해 주어진 배열을 정렬하는 방식이다.</p>\n<ul>\n<li>배열 가운데서 하나의 원소를 선택한다. (Pivot이라 칭한다.)</li>\n<li>\n<p>피봇 앞에는 피봇보다 값이 작은 모든 원소들이 위치하고, 피봇 뒤에는 피봇보다 값이 큰 모든 원소들이 위치하도록 피봇을 기준으로 배열을 둘로 분할한다. </p>\n<ul>\n<li>분할을 마친 뒤 피봇은 더 이상 움직이지 않는다.</li>\n</ul>\n</li>\n<li>분할된 두 개의 작은 배열에 대해 재귀적으로 위 과정을 반복한다.</li>\n</ul>\n<blockquote>\n<p><strong>분할 정복(Divide &#x26; Conquer)</strong>\n: 문제를 작은 2개의 겹치지 않는 문제로 분리하여 각각을 해결한 다음, 결과를 모아서 원래의 문제를 해결하는 전략</p>\n</blockquote>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">// 부분 배열을 정렬한다. 부분 배열의 크기가 충분히 작지 않은 경우 순환 호출하여 분할 정복한다.\nvoid quickSort(int[] numbers, int left, int right) {\n  if (left &gt;= right) return;\n\n  int pivot = partition(numbers, left, right);\n\n  quickSort(numbers, left, pivot - 1);\n  quickSort(numbers, pivot, right);\n}\n\n// 배열을 피봇 기준으로 비균등하게 2개의 부분 배열로 분할한다.\nint partition(int[] numbers, int left, int right) {\n  int pivot = numbers[left];\n  int i = left, j = right;\n  int tmp = 0;\n\n  while(i &lt; j) {\n    while(pivot &lt; numbers[j]) j--;\n    while(i &lt; j &amp;&amp; pivot &gt;= numbers[i]) i++;\n    tmp = numbers[i];\n    numbers[i] = numbers[j];\n    numbers[j] = tmp;\n  }\n  numbers[left] = numbers[i];\n  numbers[i] = pivot;\n\n  return i;\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 개선</h3>\n<p><code class=\"language-text\">partition()</code> 함수에서 피봇 값이 최소나 최대값으로 지정되어 부분 배열로 나눠지지 않았을 때, <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span> 의 시간 복잡도를 가진다.</p>\n<ul>\n<li>즉, 이미 배열이 정렬된 경우 최악의 시간 복잡도를 가진다.</li>\n<li>배열에서 가장 앞에 있는 값과 중간값을 교환해준다면, 시간 복잡도를 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span> 으로 개선할 수 있다.(최악의 시간 복잡도가 되는 것은 아님!)</li>\n</ul>\n<h3>🪚 장점</h3>\n<ul>\n<li>최선의 경우(매 피봇이 정확하게 두 부분 배열로 분할하는 경우), 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span> 이다. (각 순환 호출 단계의 비교 연산은 <code class=\"language-text\">N</code> 번, 총 비교 횟수는 <code class=\"language-text\">logN</code> 번)</li>\n<li>불필요한 데이터의 이동을 줄이고, 먼 거리의 데이터를 교환할 뿐만 아니라, 한 번 결정된 피봇들이 추후 연산에서 제외되는 특성으로, 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span> 인 알고리즘 중 가장 빠른 정렬 알고리즘이다.</li>\n<li>In-place sort</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>최악의 경우(이미 배열이 정렬된 경우), 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><msup><mi>N</mi><mn>2</mn></msup><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N^2)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1.064108em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\"><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"msupsub\"><span class=\"vlist-t\"><span class=\"vlist-r\"><span class=\"vlist\" style=\"height:0.8141079999999999em;\"><span style=\"top:-3.063em;margin-right:0.05em;\"><span class=\"pstrut\" style=\"height:2.7em;\"></span><span class=\"sizing reset-size6 size3 mtight\"><span class=\"mord mtight\">2</span></span></span></span></span></span></span></span><span class=\"mclose\">)</span></span></span></span> 이다.</li>\n<li>Unstable sort</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mn>1</mn><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(1)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\">1</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<blockquote>\n<p>Java의 <code class=\"language-text\">Arrays.sort()</code> 는 내부적으로 Dual Pivot Quick Sort를 사용한다.</p>\n<ul>\n<li>삽입 정렬과 퀵 정렬을 합친 개념이다.</li>\n<li>말 그대로 피봇을 2개 사용하고, 총 3개의 구역으로 분할하여 정렬한다.</li>\n</ul>\n</blockquote>\n<hr>\n<h2>🧷 병합 정렬 (Merge Sort)</h2>\n<p>합병 정렬이라고도 하며, 이 또한 분할 정복 알고리즘을 사용한다.</p>\n<ul>\n<li>영역을 쪼갤 수 있을 만큼 쪼갠 후, 합병시키면서 정렬해나간다.</li>\n</ul>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void mergeSort(int[] numbers, int left, int right) {\n  if (left &lt; right) {\n    int mid = (left + right) / 2;\n\n    // mergeSort()를 재귀적으로 계속 호출함으로써, 쪼개질 때까지 계속 쪼갬\n    mergeSort(numbers, left, mid);\n    mergeSort(numbers, mid + 1, right);\n    merge(numbers, left, mid, right);\n  }\n}\n\n// 정렬된 두 부분 배열을 순차적으로 비교하면서 병합\nvoid merge(int[] numbers, int left, int mid, int right) {\n  int[] L = Arrays.copyOfRange(numbers, left, mid + 1);\n  int[] R = Arrays.copyOfRange(numbers, mid + 1, right + 1);\n\n  int i = 0, j = 0, k = left;\n  int lenL = L.length, lenR = R.length;\n\n  while(i &lt; lenL &amp;&amp; j &lt; lenR) {\n    if (L[i] &lt;= R[j]) numbers[k] = L[i++];\n    else numbers[k] = R[j++];\n    k++;\n  }\n\n  while(i &lt; lenL) numbers[k++] = L[i++];\n  while(j &lt; lenR) numbers[k++] = R[j++];\n}</code>\n        </deckgo-highlight-code>\n<blockquote>\n<p>순차적인 비교를 통해 정렬을 수행하기 때문에 <code class=\"language-text\">LinkedList</code> 의 정렬이 필요할 때 효율적이다.</p>\n<ul>\n<li>퀵 정렬은 임의 접근이기 때문에 <code class=\"language-text\">LinkedList</code> 에 대해서는 성능이 좋지 않다.</li>\n</ul>\n</blockquote>\n<blockquote>\n<p><strong>퀵 정렬과 병합 정렬의 차이점</strong></p>\n<ul>\n<li>퀵 정렬: 우선 피봇을 통해 정렬한 후 영역을 쪼갬</li>\n<li>병합 정렬: 영역을 쪼갤 수 있을 만큼 쪼갠 후 정렬</li>\n</ul>\n</blockquote>\n<h3>🪚 장점</h3>\n<ul>\n<li>최선, 최악, 평균의 경우 모두 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span> 이다.</li>\n<li>Stable sort</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>\n<p>추가적인 메모리 공간이 더 필요하다.</p>\n<ul>\n<li>In-place sort이 아니다.</li>\n<li><code class=\"language-text\">LinkedList</code> 를 사용하면 In-place 하게 할 수 있다.</li>\n</ul>\n</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<hr>\n<h2>🧷 힙 정렬 (Heap Sort)</h2>\n<p>완전 이진 트리를 기반으로 하는 힙을(<code class=\"language-text\">Binary Heap</code>) 기반으로 하는 정렬 방식</p>\n<ul>\n<li>\n<p><code class=\"language-text\">Binary Heap</code> 을 활용한 정렬 방식은 2가지가 있다.</p>\n<ul>\n<li>정렬 대상인 데이터들을 힙에 넣었다가, 꺼내는 원리로 정렬 (inplace sort X)</li>\n<li>기존 배열을 <code class=\"language-text\">heapify</code>(<code class=\"language-text\">heap</code> 으로 만드는 과정)을 거쳐 꺼내는 원리로 정렬 (inplace sort O)</li>\n</ul>\n</li>\n<li><strong>최대 힙</strong>을 구성한다.</li>\n<li>즉, 현재 힙의 루트에는 최댓값이 존재하게 된다. 루트의 값을 마지막 노드와 바꾼 후, 힙 사이즈를 1 줄인다.</li>\n<li>힙의 사이즈가 1보다 큰 경우에 대해 위 과정을 반복한다.</li>\n<li>매 과정마다 최댓값을 맨 뒤에 위치시키면서 정렬한다.</li>\n</ul>\n<blockquote>\n<p><strong>완전 이진 트리?</strong>\n: 삽입할 때 왼쪽부터 차례대로 추가하는 이진 트리로, 마지막 레벨을 제외한 모든 레벨은 채워져 있어야 한다.</p>\n</blockquote>\n<blockquote>\n<p><strong>최대 힙, 최소 힙</strong></p>\n<ul>\n<li>최대 힙 : 각 노드의 값이 해당 <code class=\"language-text\">children</code> 의 값보다 크거나 같은 완전 이진 트리</li>\n<li>최소 힙 : 각 노드의 값이 해당 <code class=\"language-text\">children</code> 의 값보다 작거나 같은 완전 이진 트리</li>\n</ul>\n</blockquote>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void heapSort(int[] array) {\n  int n = array.length;\n  \n  // 최대 힙 구성\n  for (int i = n / 2 - 1; i &gt;= 0; i--)\n    heapify(array, n, i);\n  \n  // 최대 값 추출 후, 다시 최대 힙 구성 반복\n  for (int i = n - 1; i &gt; 0; i--) {\n    swap(array, 0, i);\n    heapify(array, i, 0);\n  }\n}\n\nvoid heapify(int[] array, int n, int i) {\n  int p = i;\n  // 부모 노드 기준으로, 왼쪽 자식 노드와 오른쪽 자식 노드 idx 지정\n  int l = i * 2 + 1;\n  int r = i * 2 + 2;\n  \n  // 왼쪽 자식노드\n  if (l &lt; n &amp;&amp; array[p] &lt; array[l])\n    p = l;\n\n  // 오른쪽 자식노드\n  if (r &lt; n &amp;&amp; array[p] &lt; array[r])\n    p = r;\n  \n  // 부모노드 &lt; 자식노드\n  if(i != p) {\n    swap(array, p, i);\n    heapify(array, n, p);\n  }\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 장점</h3>\n<ul>\n<li>\n<p>최선, 최악, 평균의 경우 모두 시간 복잡도가 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span>이다.</p>\n<ul>\n<li><code class=\"language-text\">heap</code> 에 데이터를 저장하는 시간 복잡도: <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(logN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></li>\n<li><code class=\"language-text\">heap</code> 에서 데이터를 삭제하는 시간 복잡도: <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(logN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></li>\n</ul>\n</li>\n<li>\n<p>가장 크거나 가장 작은 값을 구할 때, 최대 k 만큼 떨어진 요소들을 정렬할 때 활용한다면 효율적이다.</p>\n<ul>\n<li>최소 힙 or 최대 힙의 루트 값이기 때문에 <strong>한 번의 힙 구성</strong>을 통해 구하는 것이 가능하고, 삽입 정렬보다 더욱 개선된 결과를 얻어낼 수 있기 때문이다.</li>\n</ul>\n</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>Unstable sort</li>\n<li>데이터의 상태에 따라 같은 시간 복잡도를 가지는 다른 정렬 알고리즘에 비해 느리다.</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mi>l</mi><mi>o</mi><mi>g</mi><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(NlogN)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mord mathnormal\" style=\"margin-right:0.01968em;\">l</span><span class=\"mord mathnormal\">o</span><span class=\"mord mathnormal\" style=\"margin-right:0.03588em;\">g</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<hr>\n<blockquote>\n<p>아래 2가지의 정렬 알고리즘은 비교를 수행하지 않는 <strong><code class=\"language-text\">non-Comparisons Sorting Algorithm</code></strong> 이다.</p>\n</blockquote>\n<h2>🧷 기수 정렬 (Radix Sort)</h2>\n<p>데이터를 구성하는 기본 요소(기수: Radix)를 이용하는 정렬 방식</p>\n<ul>\n<li>낮은 자릿수부터 비교하여 하나의 버킷을 생성해 분류하고, 그 다음 자릿수를 기준으로 이를 반복한다.</li>\n<li>\n<p><strong>LSD(Least Significant Digit) 방식</strong>과 <strong>MSD(Most Significant Digit) 방식</strong>이 있다.</p>\n<ul>\n<li>LSD 방식은 덜 중요한 숫자부터 정렬하는 방식으로, 일의 자리부터 정렬한다.</li>\n<li>MSD 방식은 중요한 숫자부터 정렬하는 방식으로, 가장 큰 자릿수부터 정렬한다.</li>\n</ul>\n</li>\n</ul>\n<blockquote>\n<p>❓ <strong>낮은 자릿수부터 정렬하는 이유 (MSD와 LSD의 비교)</strong></p>\n<ul>\n<li>LSD는 중간에 정렬 결과를 볼 수 없다. 일의 자리부터 백의 자리까지 정렬을 마친 후 결과를 알 수 있다.</li>\n<li>\n<p>MSD는 중간에 정렬 결과를 확인할 수 있다. 따라서 정렬하는데 걸리는 시간을 단축시킬 수 있다.</p>\n<ul>\n<li>하지만 이때, 정렬이 완료되었는지 확인하는 과정이 필요하고, 이때 메모리를 더 사용하게 된다.</li>\n</ul>\n</li>\n</ul>\n<p>결론적으로, <strong>LSD가 MSD보다 더 일관된 알고리즘</strong>이므로, 대개 <strong>기수 정렬을 논할 때는 LSD를 논한다.</strong></p>\n</blockquote>\n<blockquote>\n<p>입력 데이터의 최댓값에 따라 정렬하는 <code class=\"language-text\">Counting Sort</code> 의 비효율성을 개선하기 위해 사용 가능하다.</p>\n<ul>\n<li>자릿수의 값 별로 정렬을 하기에 나올 수 있는 값의 최대 사이즈는 0 ~ 9(10)이다.</li>\n</ul>\n</blockquote>\n<img src='https://blog.kakaocdn.net/dn/DWH0S/btqFOYnIbCu/Q7HOAOzzvlD4xW279LqTLK/img.gif' width='80%'>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void radixSort(int[] arr, int n) {\n  // 최댓값 찾기\n  int m = Arrays.stream(arr).max().getAsInt();\n  \n  // 최댓값을 나눴을 때, 0이 나오면 모든 숫자가 exp의 아래\n  for (int exp = 1; m / exp &gt; 0; exp *= 10)\n    countSort(arr, n, exp);\n}\n\nvoid countSort(int[] arr, int n, int exp) {\n  int[] buffer = new int[n];\n  int[] count = new int[10];\n  int i = 0;\n  \n  // exp의 자릿수에 해당하는 count 증가\n  for (i = 0; i &lt; n; i++) {\n    count[(arr[i] / exp) % 10]++;\n  }\n\n  // 누적합 구하기\n  for (i = 1; i &lt; 10; i++) {\n    count[i] += count[i - 1];\n  }\n\n  // 일반적인 Counting sort 과정\n  for (i = n - 1; i &gt;= 0; i--) {\n    int idx = (arr[i] / exp) % 10;\n    buffer[count[idx] - 1] = arr[i];\n    count[idx]--;\n  }\n\n  for (i = 0; i &lt; n; i++) {\n    arr[i] = buffer[i];\n  }\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 장점</h3>\n<ul>\n<li>문자열과 정수의 정렬이 가능하다.</li>\n<li>Stable sort</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>자릿수가 없는 데이터에 대한 정렬은 불가능하다. (ex. 부동 소숫점)</li>\n<li>중간 결과를 저장할 추가적인 메모리 공간이 필요하다.</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<hr>\n<h2>🧷 계수 정렬 (Counting Sort)</h2>\n<p>말 그대로, 몇 개인지 개수를 세어 정렬하는 방식이다.</p>\n<ul>\n<li>주어진 데이터 중 가장 큰 값을 size로 하는 배열을 생성한다.</li>\n<li>배열을 탐색하며, 데이터의 등장 횟수를 해당 index에 저장한다.</li>\n<li>이후 완성된 등장 횟수 배열을 누적합으로 변경한다.</li>\n<li>\n<p>주어진 데이터 배열을 뒤에서부터 탐색하며, <code class=\"language-text\">등장 횟수 배열[주어진 데이터 배열의 값]</code> 에 해당 숫자를 위치시킨다.</p>\n<ul>\n<li>그리고 누적합 배열의 값을 1씩 감소시킨다.</li>\n</ul>\n</li>\n</ul>\n<img src='https://t1.daumcdn.net/cfile/tistory/22538A4D56D2FFBA2E' width='80%'>\n<img src='https://t1.daumcdn.net/cfile/tistory/23057D4956D2FFE314' width='80%'>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">void countingSort(int[] numbers) {\n  int[] sortedArr = new int[numbers.length];\n  int[] counting = new int[Arrays.stream(numbers).max().getAsInt() + 1];\n\n  // 등장 횟수 계산\n  for (int num : numbers)\n    counting[num]++;\n\n  // 누적합 계산\n  for (int i = 1; i &lt; counting.length; i++)\n    counting[i] += counting[i - 1];\n\n  // 누적합 배열과 주어진 데이터를 이용해 정렬 수행\n  for (int i = numbers.length - 1; i &gt;= 0; i--) {\n    sortedArr[counting[numbers[i]] - 1] = numbers[i];\n    counting[numbers[i]]--;\n  }\n\n  System.out.println(Arrays.toString(sortedArr));\n}</code>\n        </deckgo-highlight-code>\n<h3>🪚 장점</h3>\n<ul>\n<li>최선의 경우 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span>의 시간 복잡도를 가져, 가장 빠른 정렬 알고리즘이다.</li>\n<li>Stable sort</li>\n<li>\n<p>정렬할 데이터가 특정한 범위 안에 있는 경우 자주 사용한다.</p>\n<ul>\n<li>대표적으로는 26개의 알파벳으로 이루어진 문자열에서 <code class=\"language-text\">Suffix Array</code> 를 얻는 경우이다.</li>\n</ul>\n</li>\n</ul>\n<h3>🪚 단점</h3>\n<ul>\n<li>\n<p>데이터의 최댓값에 해당하는 만큼의 추가적인 메모리 공간이 필요하기에(누적합 배열에 접근하는 시간을 <span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mn>1</mn><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(1)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord\">1</span><span class=\"mclose\">)</span></span></span></span>로 하기 위해) 대부분의 경우 엄청난 <strong>메모리 낭비</strong>를 야기할 수 있다.</p>\n<ul>\n<li>만약 주어진 데이터의 값 범위가 너무 큰 경우, 사용하지 않는 메모리 공간의 낭비도 발생하게 된다.</li>\n</ul>\n</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">Time Complexity</th>\n<th align=\"center\">Space Complexity</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n<td align=\"center\"><span class=\"katex\"><span class=\"katex-mathml\"><math xmlns=\"http://www.w3.org/1998/Math/MathML\"><semantics><mrow><mi>O</mi><mo stretchy=\"false\">(</mo><mi>N</mi><mo stretchy=\"false\">)</mo></mrow><annotation encoding=\"application/x-tex\">O(N)</annotation></semantics></math></span><span class=\"katex-html\" aria-hidden=\"true\"><span class=\"base\"><span class=\"strut\" style=\"height:1em;vertical-align:-0.25em;\"></span><span class=\"mord mathnormal\" style=\"margin-right:0.02778em;\">O</span><span class=\"mopen\">(</span><span class=\"mord mathnormal\" style=\"margin-right:0.10903em;\">N</span><span class=\"mclose\">)</span></span></span></span></td>\n</tr>\n</tbody>\n</table>\n<hr>\n<h2>📕 참고</h2>\n<ul>\n<li><a href=\"https://gyoogle.dev/blog/algorithm/Bubble%20Sort.html\">Tech Interview for developer</a></li>\n<li><a href=\"https://github.com/JaeYeopHan/Interview_Question_for_Beginner/tree/master/Algorithm\">JaeYeopHan/Interview<em>Question</em>for_Beginner</a></li>\n<li><a href=\"https://velog.io/@cookncoding/%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98-%EA%B0%9C%EB%85%90-Stable-Sort-Inplace\">[알고리즘 개념] Stable Sort &#x26;Inplace</a></li>\n<li><a href=\"https://hevton.tistory.com/192\">양방향 버블 정렬</a></li>\n<li><a href=\"https://cs-vegemeal.tistory.com/53\">[Dual-Pivot Quick Sort] 두 개의 피봇으로 퀵 정렬</a></li>\n<li><a href=\"https://bowbowbow.tistory.com/8\">Counting Sort : 계수 정렬</a></li>\n<li><a href=\"https://herong.tistory.com/entry/%EA%B8%B0%EC%88%98%EC%A0%95%EB%A0%ACRidix-Sort?category=818669\">기수 정렬-Radix Sort</a></li>\n</ul>","frontmatter":{"title":"💡 Sorting 알고리즘","date":"April 24, 2022","update":"May 05, 2022","tags":["개발상식","Java","정렬"],"series":"💡 Algorithm"},"fields":{"slug":"/[Algorithm]Sorting 알고리즘/","readingTime":{"minutes":23.74}}},"seriesList":{"edges":[{"node":{"id":"b0e662c4-8dab-58b1-8e34-76fd1f26ad52","fields":{"slug":"/[Algorithm]graph/"},"frontmatter":{"title":"💡 Graph 이론"}}},{"node":{"id":"c1c6944f-734a-5276-8604-a897181207ae","fields":{"slug":"/[Algorithm]문제해결개관/"},"frontmatter":{"title":"💡 문제해결개관"}}},{"node":{"id":"b783c57f-f958-5c14-9935-06b16995e8f1","fields":{"slug":"/[Algorithm]알고리즘분석/"},"frontmatter":{"title":"💡 알고리즘 분석"}}},{"node":{"id":"f3c7f32a-2ead-5bd5-a198-ee5342823217","fields":{"slug":"/[Algorithm]Sorting 알고리즘/"},"frontmatter":{"title":"💡 Sorting 알고리즘"}}},{"node":{"id":"07844ce0-f154-5ad8-b4cc-c6e9bebecc21","fields":{"slug":"/[Algorithm]이분 탐색/"},"frontmatter":{"title":"💡 이분 탐색(Binary Search)"}}},{"node":{"id":"66ab5e60-ccc9-5f85-ad77-8457be4014db","fields":{"slug":"/[Algorithm]HashTable/"},"frontmatter":{"title":"💡 해시 테이블 (Hash Table)"}}},{"node":{"id":"8aa61523-9a0a-5cc7-a670-9750d851b450","fields":{"slug":"/[Algorithm]최장증가수열(LIS)/"},"frontmatter":{"title":"💡 최장 증가 수열(LIS)"}}},{"node":{"id":"db216133-c9cd-5948-babf-f437eb127d7c","fields":{"slug":"/[Algorithm]DynamicProgramming/"},"frontmatter":{"title":"💡 DP (Dynamic Programming)"}}},{"node":{"id":"fa96dd6e-75c9-5a7c-887c-1993125cc7f0","fields":{"slug":"/[Algorithm]최소공통조상(LCA)/"},"frontmatter":{"title":"💡 최소 공통 조상(LCA)"}}},{"node":{"id":"268a7d15-795c-5e9f-9770-eeda9132721d","fields":{"slug":"/[Algorithm]다익스트라알고리즘/"},"frontmatter":{"title":"💡 다익스트라(Dijkstra) 알고리즘"}}},{"node":{"id":"f3a9bade-22f4-54b0-ad9a-b642d6f2b754","fields":{"slug":"/[Algorithm]비트마스크/"},"frontmatter":{"title":"💡 비트마스크(BitMask)"}}}]},"previous":{"fields":{"slug":"/[Programmers]42862/"},"frontmatter":{"title":"👩‍💻 42862. 체육복"}},"next":{"fields":{"slug":"/[Programmers]67256/"},"frontmatter":{"title":"👩‍💻 67256. 키패드 누르기"}}},"pageContext":{"id":"f3c7f32a-2ead-5bd5-a198-ee5342823217","series":"💡 Algorithm","previousPostId":"9da2693a-dfe4-59c6-9388-f61498de5717","nextPostId":"33a54365-0a97-5b0f-bb98-2c9cd3bd01e6"}},"staticQueryHashes":[]}